[지디넷코리아]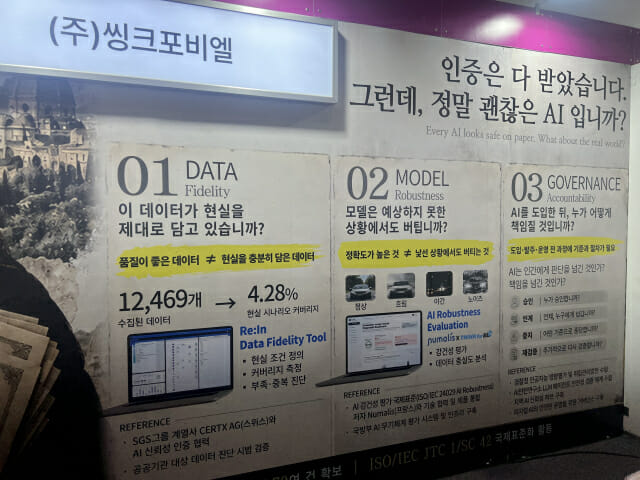
인공지능(AI) 성능을 높이기 위해 무조건 많은 데이터를 학습시키기보다 중복되거나 편향된 데이터를 걸러내고 목적에 맞는 데이터를 선별하는 것이 중요하다는 지적이 나왔다. 데이터 양보다 품질과 구성이 AI 신뢰성을 좌우할 수 있다는 설명이다.
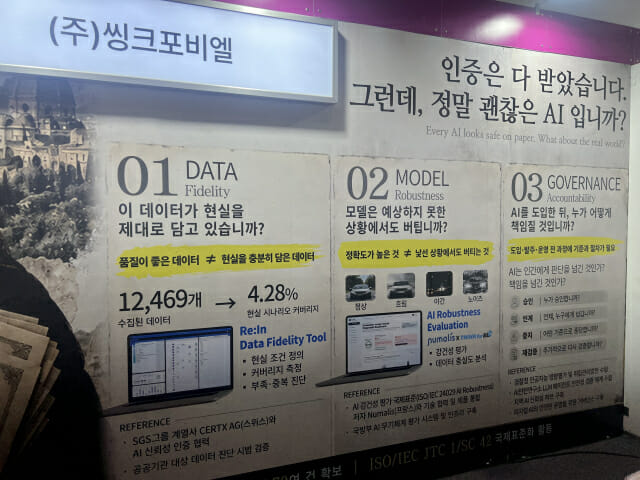
AI 신뢰성 전문기업 씽크포비엘은 7일 서울 코엑스에서 열린 ‘AI 페스타 2026’에서 AI 학습데이터를 진단하고 편향 등을 검증하는 기술을 선보였다.
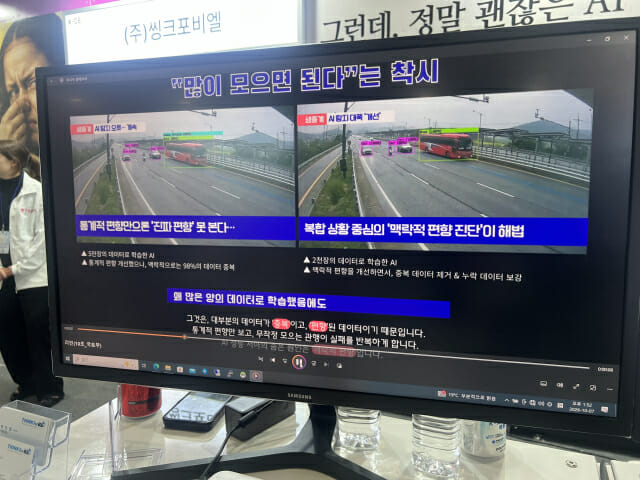
씽크포비엘은 이날 부스에서 서로 다른 규모의 이미지 데이터를 학습한 AI를 비교해 데이터 양과 AI 성능이 반드시 비례하지 않는다는 점을 소개했다. 한쪽은 5만장의 이미지 데이터를, 다른 한쪽은 2천장의 데이터를 이용해 AI를 학습시킨 사례다.
핵심은 데이터가 얼마나 많은지가 아니라 AI가 목적에 맞게 작동할 수 있도록 적절한 데이터가 구성됐느냐다.
씽크포비엘 관계자는 “데이터가 많다고 해서 AI가 제대로 작동하는 것은 아니다”며 “많은 데이터 안에 중복되거나 편향된 데이터가 포함될 수 있기 때문에 이를 걸러내고 적정한 수준의 데이터를 이용해 AI가 제대로 작동하도록 진단하는 것이 중요하다”고 설명했다.
씽크포비엘은 이 같은 문제를 ‘맥락적 편향’ 관점에서 분석한다. 데이터 자체에 오류가 없더라도 특정 데이터가 지나치게 많거나 데이터 구성이 실제 AI가 사용될 환경을 제대로 반영하지 못하면 AI 판단 결과가 왜곡될 수 있다는 것이다.
회사는 자체 AI 데이터 신뢰성 검증 솔루션 ‘리인’을 통해 학습데이터의 편향성과 중복 등을 분석한다. AI 개발 기업이 모델 학습에 사용할 데이터를 점검하거나 공공기관이 AI 시스템을 발주·도입하는 과정에서 신뢰성과 품질을 검증하는 데 활용할 수 있다.
특히 공공 분야에서 AI 신뢰성 검증 수요가 커지고 있다는 설명이다. 공공기관이 도입한 AI가 잘못된 판단을 내릴 경우 책임 문제가 발생할 수 있어 모델 성능뿐 아니라 데이터와 개발·운영 과정 전반을 검증해야 하기 때문이다.
씽크포비엘은 경찰청과 AI 신뢰성 관련 사업을 진행했으며 국방 분야에서는 국방기술품질원과 세 차례 협력했다. AI를 공공·치안·국방처럼 높은 신뢰성이 요구되는 분야에 적용하기 위해 품질과 안전성을 확보하는 것이 주요 과제다.
씽크포비엘은 향후에도 AI 신뢰성을 핵심 사업으로 삼고 국제표준과 연계한 사업을 확대할 계획이다. 해외 기관과 협력해 자체 기준만 적용하는 것이 아니라 국제적으로 통용되는 AI 신뢰성 기준에 맞춰 기업들의 AI 개발과 검증을 지원한다는 구상이다.
씽크포비엘 관계자는 “중요한 것은 씽크포비엘만의 기준으로 AI 신뢰성을 판단하는 것이 아니다”며 “세계 표준과 함께 가면서 기업들도 국제표준에 맞춰 AI를 만들 수 있도록 하는 방향을 중요하게 보고 있다”고 말했다.
AI 페스타 2026은 과학기술정보통신부가 주최하고 한국인공지능·소프트웨어산업협회(KOSA)와 AI페스타조직위원회가 주관하는 인공지능주간 공식 행사다. 올해 행사는 6일부터 8일까지 사흘간 서울 코엑스 C홀에서 열린다. 국내외 AI 기업·기관 약 350개사가 참여해 500여개 부스를 운영하며 AI 코어, 에이전틱 AI, 피지컬 AI, AI 보안, 국방 AI, AI 반도체 등 다양한 기술과 산업 적용 사례를 선보인다.