[지디넷코리아]
정부가 인공지능(AI) 학습·연구 등에 활용할 수 있도록 개방한 AI허브 데이터 150종의 개인정보 잔존 여부를 다시 점검한다. 1차 비식별화가 완료된 데이터에서 개인정보나 민감정보가 남아 있는지 재검증하고, 발견될 경우 추가 비식별화해 공개 데이터의 안전성과 신뢰성을 확보한다는 취지다.
29일 업계에 따르면 한국지능정보사회진흥원(NIA)은 ‘통합제공체계·AI허브 기개방 데이터 개인정보 재검증 및 비식별 용역’을 발주하고 사업자 선정에 나섰다. 사업 예산은 3억원 규모이며 계약 체결일부터 오는 12월까지 약 두 달간 진행된다.
대상은 텍스트·이미지·영상 등 멀티모달 형태의 AI허브 개방 데이터 150종이다. NIA는 수행사에 그래픽처리장치(GPU)·클라우드·서버 등 인프라를 별도로 제공하지 않고 자체 인프라를 확보해 사업을 수행하도록 했다.
AI허브는 정부가 AI 기술·제품·서비스 개발에 필요한 데이터를 제공하기 위해 운영하는 국가 AI 데이터 플랫폼이다. 정부는 지난 4월 공공부문이 보유한 AI 학습용데이터를 대상으로 범부처 첫 전수조사에 착수했다. 활용 가능성이 높은 데이터 100종을 선정해 품질 보완과 비식별화 등을 거쳐 통합제공체계를 통해 제공한다는 계획도 밝혔다.
이번 재검증에서는 텍스트·이미지·영상 등 데이터 유형별로 개인정보와 민감정보가 남아 있는지를 확인한다. 이름·연락처 같은 정보뿐 아니라 이미지·영상에 포함된 얼굴, 차량번호판 등 식별 가능 정보도 점검 대상이다.
NIA는 우선 데이터셋별 샘플을 추출해 자동·수동 방식으로 개인정보와 민감정보 잔존 여부를 확인한다. 관련 정보가 탐지된 데이터셋은 전체를 대상으로 정밀 검수하고, 재탐지된 정보에 대해서는 데이터 유형별 특성에 맞춰 추가 비식별화를 실시한 뒤 적정성도 검증한다.
사업은 11월 개인정보 탐지·비식별화와 정밀 검수 및 적정성 평가를 진행한 뒤 12월 개별 결과보고서 작성과 최종 데이터셋 업로드를 완료하는 일정이다. 150개 데이터셋 각각에 대해 개인정보 탐지 결과와 조치 전·후 샘플, 적용한 비식별화 기법, 적정성 검증 결과 등을 담은 보고서도 작성한다.
AI 학습용 데이터의 활용을 확대하는 동시에 개인정보 등 권리 보호 수준을 높이려는 움직임도 이어지고 있다. 전날 국회 법제사법위원회는 각 부처와 기관에 분산된 AI 학습용 데이터를 한곳에서 관리하고 민간에 제공하는 ‘통합제공시스템’ 구축 근거를 담은 AI기본법 개정안을 의결했다.
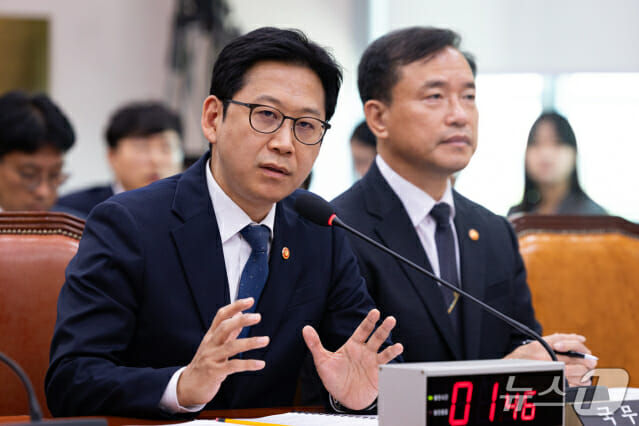
배경훈 부총리 겸 과학기술정보통신부 장관은 지난 28일 통합 데이터 플랫폼 구축과 관련해 “권리 침해가 발생할 수 있는 정보는 사전에 삭제하거나 제외하는 계획을 추진하겠다”며 “국민들이 안심하고 신뢰할 수 있도록 데이터 안전 관리 체계를 더욱 강화하겠다”고 말했다.